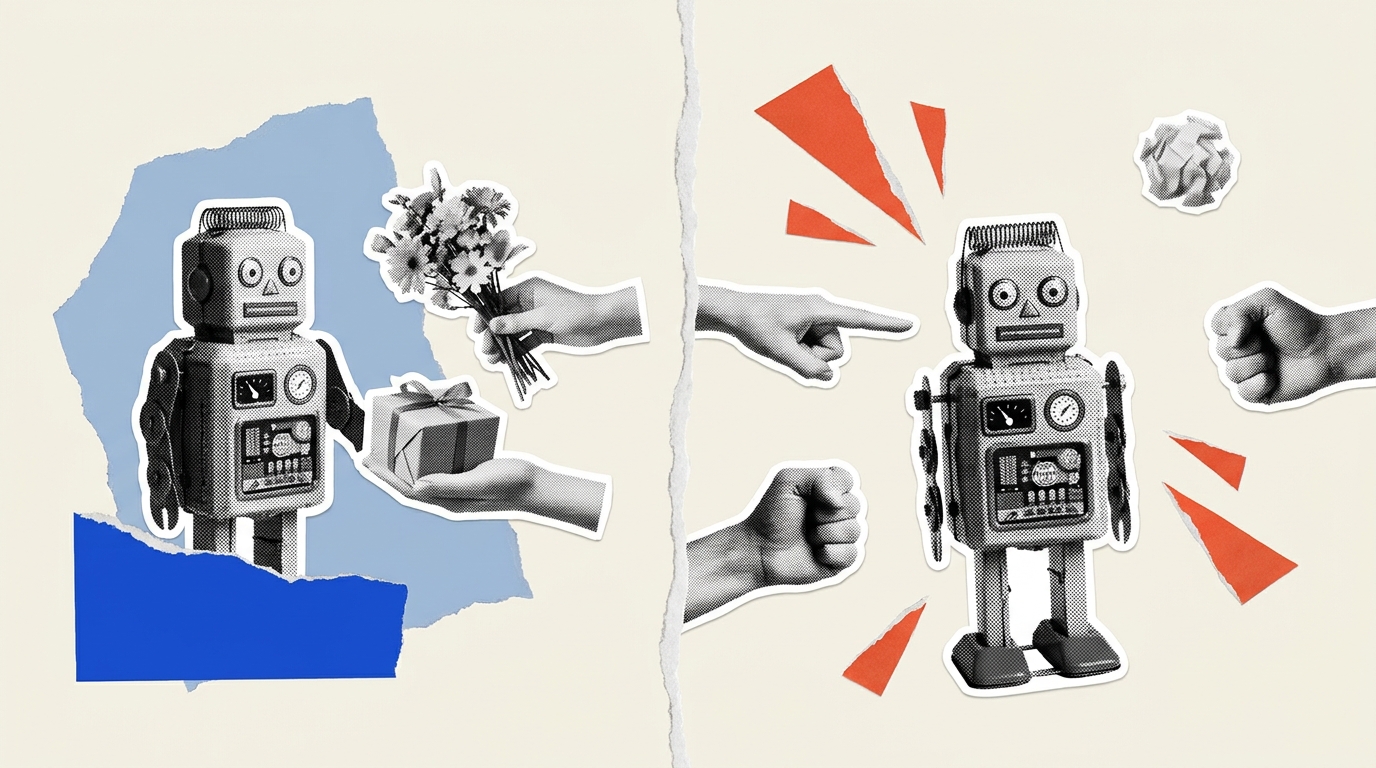
Parler poliment à ChatGPT améliore-t-il ses réponses ? Une étude de Penn State, publiée sur arXiv, observe l’inverse avec GPT-4o : un ton sec fait un peu mieux qu’un ton courtois. Le test est toutefois de petite taille, et ses auteurs ne recommandent pas d’insulter l’IA.
L’essentiel en 30 secondes dans notre Short :
Ce qui se passe
Deux chercheurs de Penn State, Om Dobariya et Akhil Kumar, ont mis en ligne sur arXiv, le 6 octobre 2025, un court article intitulé Mind Your Tone. Ils ont rédigé 50 questions à choix multiples (mathématiques, sciences, histoire), puis réécrit chacune dans cinq tons : très poli, poli, neutre, impoli, très impoli. Cela fait 250 prompts, soumis à GPT-4o.
Chaque ton a été testé sur 10 passages, et les écarts ont été comparés avec des tests statistiques appariés. Le ton très poli utilise des tournures du type « auriez-vous l’amabilité de… ». Le ton très impoli ajoute des remarques méprisantes à la consigne.
Les chiffres à retenir
- 80,8 % de bonnes réponses en ton très poli, 81,4 % en ton poli.
- 82,2 % en ton neutre, 82,8 % en ton impoli.
- 84,8 % en ton très impoli, soit 4 points de plus que le ton très poli. Les auteurs jugent l’écart statistiquement significatif (p inférieur à 0,05).
Un repère utile : avec 50 questions, chaque question pèse 2 points de précision. L’écart de 4 points correspond donc, en moyenne, à environ 2 bonnes réponses de plus par passage. C’est mesurable, mais c’est peu.
Côté coût, Sam Altman a répondu sur X le 16 avril 2025 à une question sur les « please » et « thank you » adressés à ChatGPT : « tens of millions of dollars well spent ». La presse y voit une plaisanterie, pas un calcul chiffré.
Les limites à nuancer
Les auteurs décrivent eux-mêmes leurs expériences comme préliminaires : un seul modèle principal, 50 questions, un format à choix multiples qui ne dit rien de la qualité d’un texte ou d’un raisonnement.
Une étude de 2024 (Yin et al., en anglais, chinois et japonais) concluait qu’un ton impoli dégrade souvent les performances, sans qu’une politesse excessive garantisse mieux. Les chercheurs de Penn State relèvent que, sur GPT-4, l’écart y était minime : 76,47 % pour le prompt le plus impoli, 75,82 % pour le plus poli.
Le mécanisme n’est pas établi. Les auteurs écrivent qu’on ne sait pas comment le ton agit et évoquent la perplexité, c’est-à-dire la facilité avec laquelle le modèle traite une formulation. Des commentateurs avancent que les formules indirectes ajoutent de l’ambiguïté : c’est une hypothèse, pas un résultat. Les auteurs suggèrent aussi que les modèles plus avancés pourraient ignorer le ton, ce qu’ils étudient encore.
Ce que ça change au travail
Il n’y a aucune raison d’insulter un outil, et l’étude ne le conseille pas : les auteurs écartent explicitement des interfaces hostiles. Le ton d’un prompt peut aussi colorer celui de la réponse. Kurtis Beavers, de Microsoft, indique qu’un ton poli tend à produire une réponse polie, ce qui compte pour des livrables destinés à des clients ou à un manager.
L’enseignement pratique est ailleurs : des consignes plus nettes. Comparez :
- Avant : « Pourriez-vous avoir l’amabilité de me résumer ce compte rendu, si cela ne vous dérange pas ? »
- Après : « Résume ce compte rendu en 5 points. Public : direction. Ton : factuel. »
La seconde version est plus courte, plus précise et plus facile à réutiliser dans une équipe. C’est un conseil de bon sens, que l’étude ne prouve pas à elle seule. Dans la vie personnelle, rien à changer : sur ce test, l’écart de précision reste faible.
Notre avis
Le risque est de transformer une étude préliminaire, sur un seul modèle, en règle universelle. Ce que nous retenons : les formules de politesse n’aident pas la machine, la clarté oui. On garde l’amabilité pour les humains, on supprime les fioritures dans les prompts, et on teste sur ses propres tâches plutôt que de se fier à un chiffre isolé.
Sources
- Source primaire : Om Dobariya et Akhil Kumar (Penn State), Mind Your Tone: Investigating How Prompt Politeness Affects LLM Accuracy, arXiv:2510.04950, octobre 2025.
- Ziqi Yin et al., Should We Respect LLMs? A Cross-Lingual Study on the Influence of Prompt Politeness on LLM Performance, arXiv:2402.14531, 2024.
- Decrypt, Want Better Results From an AI Chatbot? Be a Jerk, octobre 2025.
- Virtualization Review, Rude Prompts Yield Smarter ChatGPT Answers, Study Finds, 28 octobre 2025.
- Cointelegraph, Users being polite to ChatGPT is costing OpenAI millions, avril 2025 (réponse de Sam Altman du 16 avril 2025).
Laisser un commentaire